未分类
理解 Julia-1:本地运行与评测解读
介绍 Julia-1 决策模型的用途、Python 本地安装和调用方式,并说明公开基准结果的范围,以及它与 Jev AI 的使用差异。
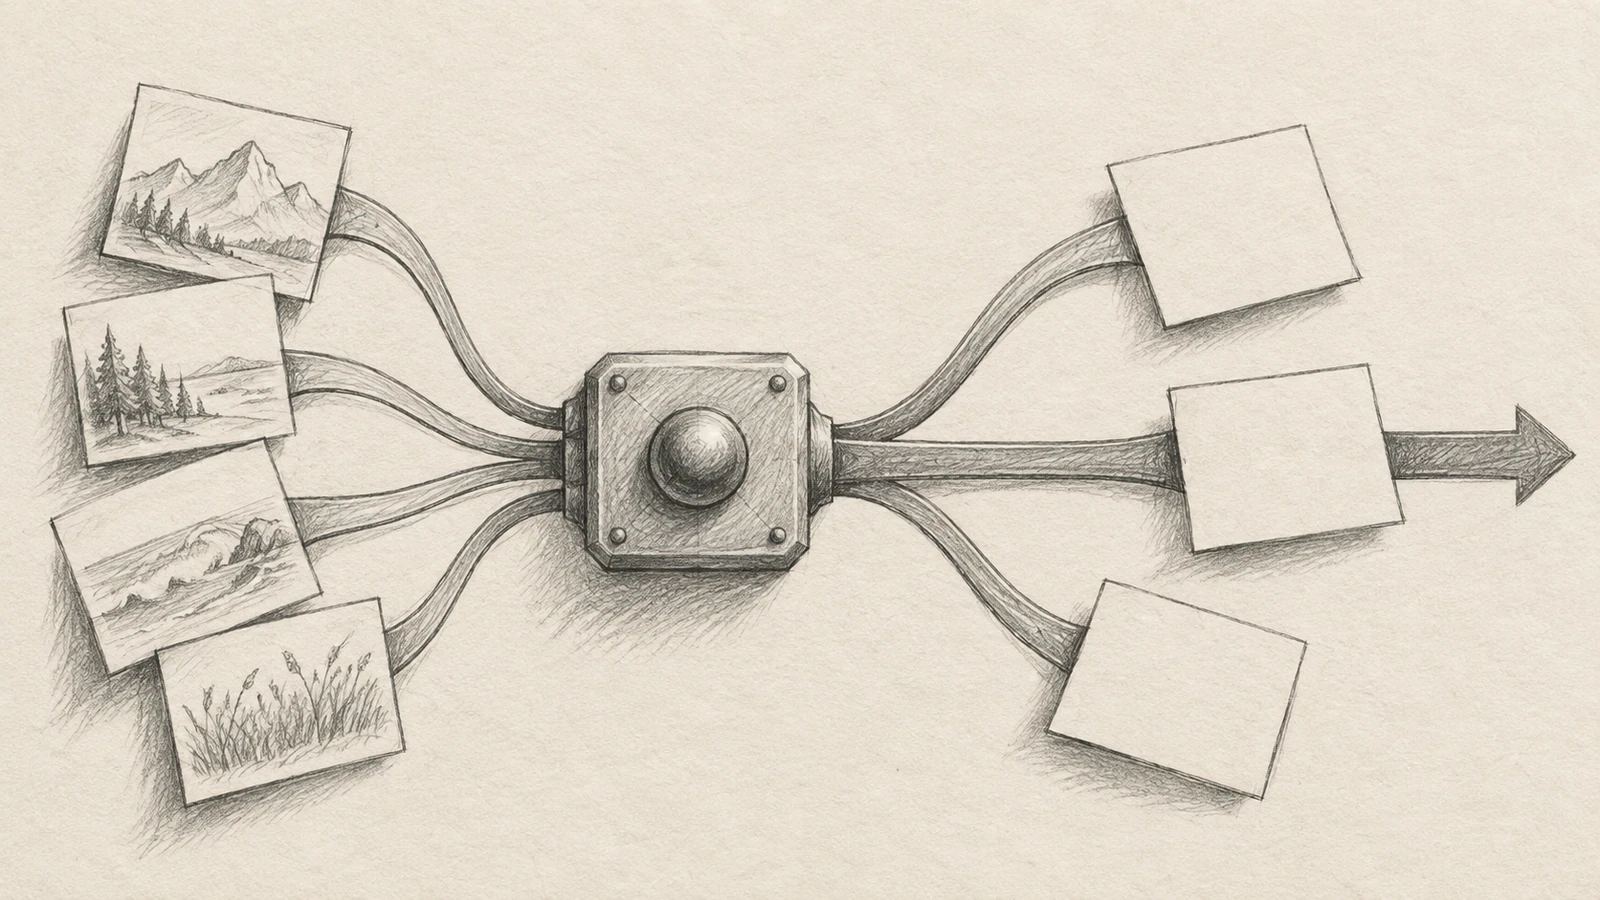
Julia-1 是一个开放权重的决策模型。给它一段状态信息、一个问题和少量候选答案,它会为这些答案打分,并返回结构化判断。
这种接口适合需要分流工单、分类请求或估计紧急程度的软件。聊天模型可以用一段话解释答案,但应用代码往往只需要一个已知标签,然后再检查和使用它。
本文会介绍 Julia-1 的工作方式、如何用 Python 运行,以及模型卡中的基准数字能说明什么、不能说明什么。最后也会比较本地运行 Julia-1 与托管式 Jev 工作流的差别。
一、Julia-1 是什么
假设一家网店收到「包裹还没送到」的留言。订单系统已经拿到了用户的话和订单资料,现在只需要判断这件事应该交给物流、账单还是账户团队。
Julia-1 把这类信息作为 state(状态),再针对应用提出的 question(问题) 比较候选答案。它会返回选中的选项和概率分数。至于要不要创建工单、转人工或执行其他动作,仍由你的程序决定。
Julia-1 checkpoint 约有 1.443 亿个参数。它基于 JHU CLSP 的多语言 mmBERT-small 编码器,并增加了用于候选答案评分的决策头。它是用于有限选项判断的编码器模型,不会生成长篇文本,也不是通用聊天助手。
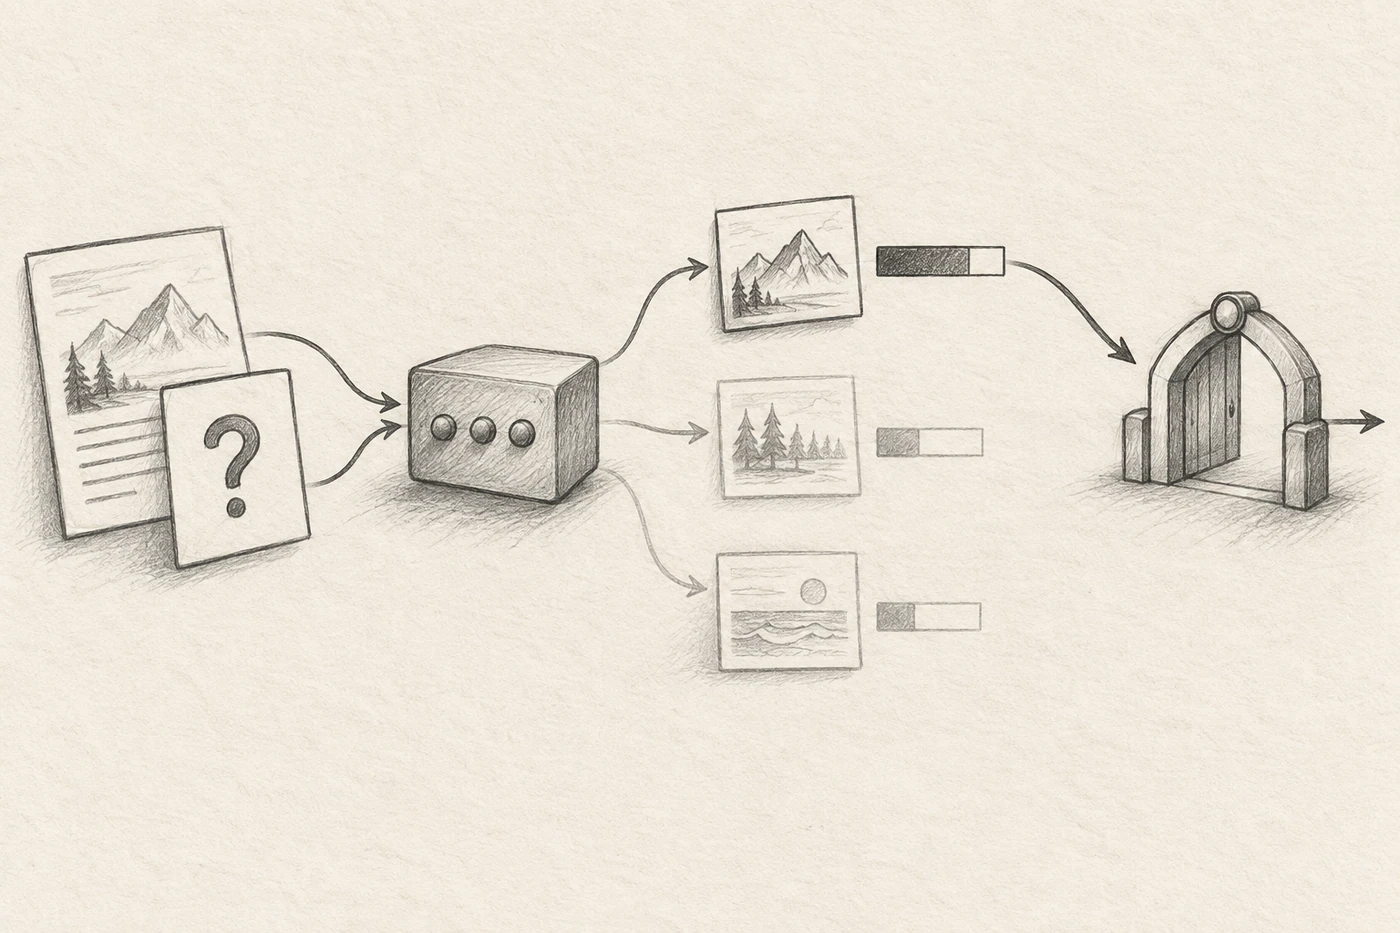
模型卡介绍了三种决策类型:
- choice: 从命名选项中选择一个,例如 shipping(物流)或 billing(账单)。
- score: 按有顺序的标准返回期望位置索引(从 0 开始),例如一般、紧急、业务阻塞。
- noul: 返回一个明确的是非命题为真的概率。
一次原生问题可接收 2 到 20 个选项。命名问题可以放在同一次请求中,结果会保留你提供的问题 ID。概率值可以帮助比较候选项,却不能保证结论正确。若要让概率阈值触发客户操作或不可逆动作,必须先用自己的数据验证。
二、在本地安装 Julia-1
Julia-1 需要 Python 3.11 或更高版本,并支持 CPU 推理,因此入门时不需要 GPU。模型 checkpoint 约有 550.5 MiB,运行时还要为 tokenizer 和推理过程中的中间数据预留内存。
Hugging Face 仓库中包含模型文件和 Python 运行代码。先下载完整快照,再从本地目录安装:
python -m pip install huggingface_hub
python -c "from huggingface_hub import snapshot_download; snapshot_download('SupersonicLabs/Julia-1', local_dir='Julia-1')"
python -m pip install -e ./Julia-1
这一步会下载实际权重,并不是只安装一个在推理时再下载模型的小软件包。请保留完整目录,并从该目录安装。Julia-1 的模型文件根据模型卡采用 Apache-2.0 许可;其私有训练流程没有一并发布。
三、用 Python 做一次类型化判断
安装后,加载模型一次,并在多次请求之间复用 engine。下面的例子根据一条客服消息选择处理团队:
from julia import load_model

engine = load_model(
    "Julia-1",
    device="cpu",
    strict_encoding=True,
    max_length=1024,
)

state = "客户说包裹迟迟没有送到。"

questions = {
    "team": {
        "type": "choice",
        "instructions": "这条请求应该交给哪个团队处理?",
        "criteria": {
            "shipping": "物流跟踪、延迟或包裹丢失",
            "billing": "扣款、账单或退款",
            "account": "登录和账户资料访问",
        },
    },
}

result = engine.predict(state=state, questions=questions)
answer = result["answers"]["team"]

print(answer["choice"])
print(answer["probabilities"])
criteria 为每个选项定义 ID 和简短含义。尽量让各个标签的描述互不混淆。如果真实工作中还会出现其他情况,应加入 other 这样的兜底选项。
示例将输入长度设置为 1,024 tokens,因为模型卡中的历史准确率是在这个长度下测得的。当前运行环境支持更长输入:state、问题和选项合计最多可到 8,192 tokens,模型卡也报告通过了 8,192-token 的 CPU 冒烟测试。但这个长度下的任务准确率还没有得到验证。设置 strict_encoding=True 后,超长请求会报错,而不是悄悄截断。
如果候选项超过 20 个,仓库还介绍了分组、逐步缩小范围的层级 Router。这种做法可以处理更大的选项集合,但它不是一次原生模型调用同时比较所有标签,最后返回的概率也只覆盖筛选后的候选项。使用时要评估完整的路由流程。
四、Julia-1 与 Jev AI 的区别
Julia-1 和 Jev AI 都采用相似的决策交互方式:输入上下文,再请求一种类型化结果。主要区别是模型在哪里运行,以及谁负责维护推理服务。
| Julia-1 | 通过 Jev AI Model 使用 Jev | |
|---|---|---|
| 模型访问 | 可下载的开放权重 | 托管模型;Jev AI Model 不分发其权重 |
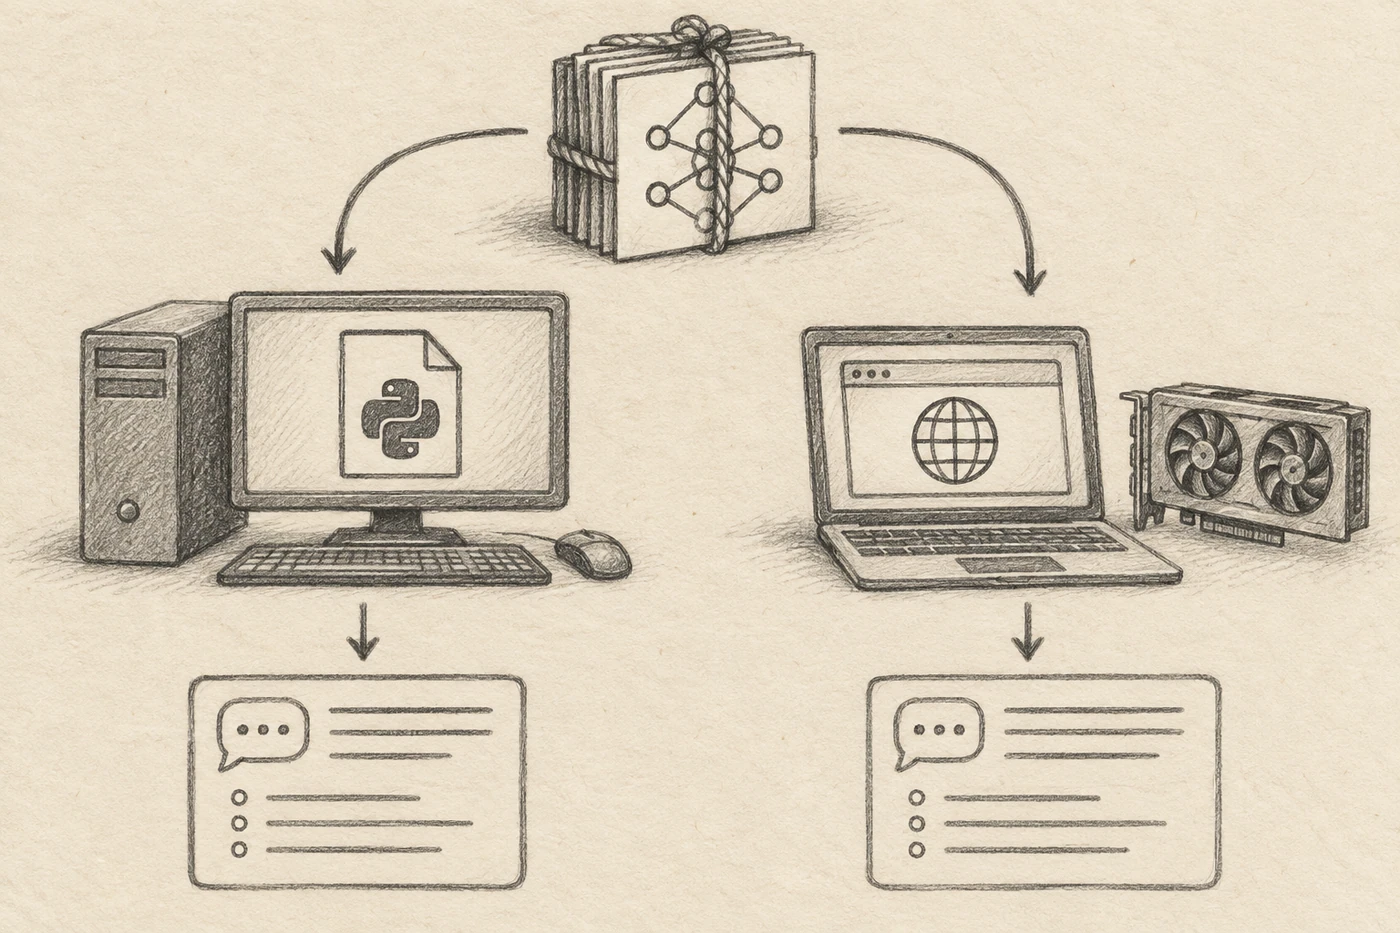
| 运行方式 | 在自己的 CPU 或 GPU 上运行 Python;另有 ONNX 浏览器 WebGPU 版本 | 网页 Playground 和托管 API |
| 前期准备 | 下载约 550.5 MiB 的权重并维护运行环境 | 登录后网页试用,或配置 API key |
| 费用与运维 | 自建推理没有托管调用费,但硬件和运维仍有成本 | 登录后 Playground 可免费使用;API 调用使用付费积分 |
| 控制范围 | 自行选择主机并管理模型文件 | 由托管服务负责推理 |
如果想先从浏览器体验,可以使用 Jev AI Model:登录后 Playground 免费,应用通过 API 调用则使用付费积分。它是访问 Jev 的独立托管服务,并不是 Julia-1 的发布方或模型开发者。
如果团队需要下载权重、在本地运行,或直接控制模型环境,可以评估 Julia-1。如果只是想快速试验决策工作流,不想先下载半个 GB 的 checkpoint,托管服务可能更省准备时间。这是部署方式的选择,不代表两个模型会给出相同预测。
五、如何理解 Julia-1 的评测
Julia-1 模型卡报告的测量日期是 2026 年 9 月 24 日,使用 H200、BF16 推理和严格编码。报告列出了不同数据集和任务,因此单一的准确率不能代表它在所有语言和场景中的表现。
| 评测 | Julia-1 结果 | 代表的范围 |
|---|---|---|
| Typed decisions | 73.15%(1,463 / 2,000) | 400 个案例,每个案例含 5 个类型化问题 |
| MASSIVE 场景分类 | 52 种语言宏平均准确率 71.50% | 18 个场景标签;不衡量意图分类或槽位填充 |
| AG News 试测 | 94 / 100 | 4 个标签,100 条样本 |
| DAIR Emotion 试测 | 86 / 100 | 6 个标签,100 条样本 |
| Banking77 试测 | 64 / 100 | 100 条样本;72 个标签先排序并缩小到前 16 个候选项 |
模型卡也在部分结果旁列出了 Jev 对比参考值:Typed decisions 为 72.70%,AG News 为 91%,Emotion 为 48%,Banking77 为 87%。模型卡说明,这些数字是另外提供的参考值,并不是 Julia 团队重新运行的 Jev 结果。试测样本较少;Banking77 的 72 个标签也经过前 16 项候选缩减,而不是一次原生 72 选 1。因此,这些数字只能说明特定测试中的结果,不能当成适用于所有场景的模型排名。
如果要把 Julia-1 用于自己的应用,应使用准备部署的确切 checkpoint、语言、输入格式、选项和硬件进行评测。留出一批测试样本,按类别检查误差,并记录自己机器上的延迟与内存。高影响任务还应包含模糊输入,并规定哪些结果需要人工复核。
六、Julia-1 适合做什么,又不适合做什么
Julia-1 的工作是比较你提供的候选答案。不要指望它补充 state 中没有的事实、撰写解释、完成多步计算,或自动知道未写入状态和标准中的业务规则。它的能力边界来自这个有限选项接口。
建议先从数量较少、含义清楚的选项开始。用直白语言写明每个标签的含义;适用时保留 other;并确认输入里包含做判断所需的信息。然后用业务专家标注的样本同时测试简单和容易混淆的案例。
Julia-1 模型卡列出的模型文件采用开放许可,但这也把下载、算力、监控、更新和访问控制等工作留给运行它的团队。Julia-1 ONNX 仓库另提供浏览器 WebGPU 路径:它在不同运行环境中使用同一模型权重,并要求浏览器和设备支持相应的 WebGPU 能力。
Julia-1 为结构化分类和路由提供了一种紧凑的试验方案。正式使用前,先用自己的样本衡量效果,并让最终业务动作继续由应用代码控制。
资料核对日期: 2026 年 9 月 27 日。文中的评测日期来自模型卡;checkpoint、命令和运行环境后续可能变化。