未分类
理解 Laya Model:安装、使用与 Jev AI 对比
介绍 Laya 模型家族、Python 安装与本地 API 用法,并结合公开评测分析 Laya 和 Jev AI 的差别与适用场景。
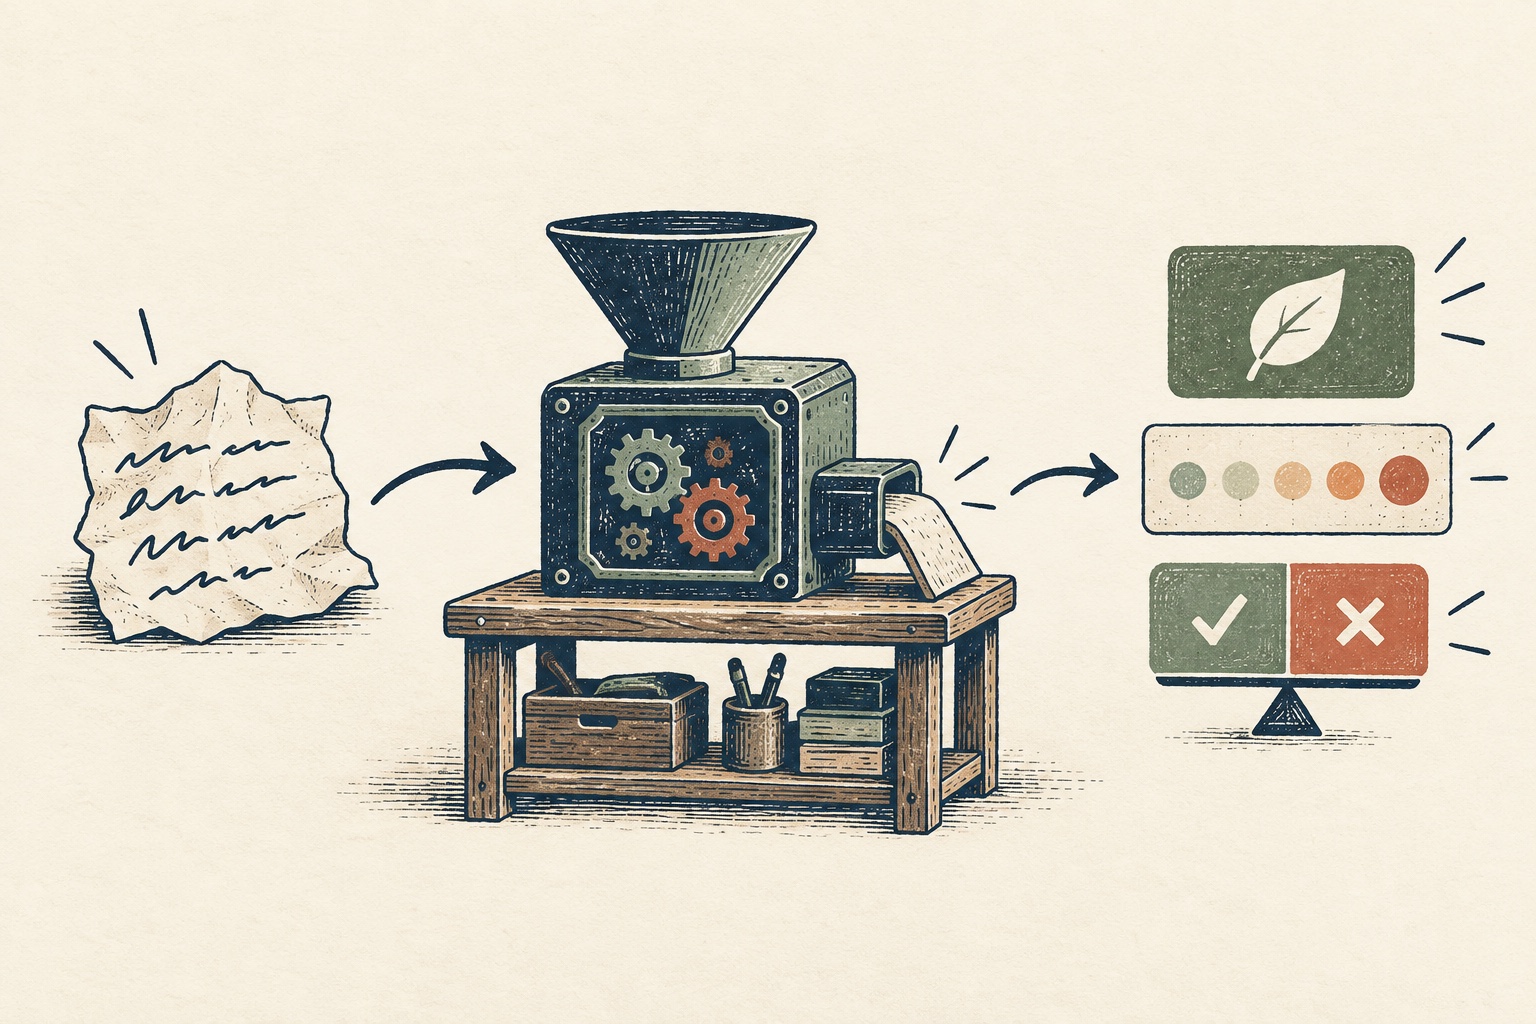
Laya 是一个开放权重的决策模型。给它一段状态信息和若干类型化问题,它会返回分类、等级评分或是非概率等结构化结果。
这让 Laya 和常见的聊天模型有所不同。它主要为软件提供边界明确的判断,并不会针对每个结果写一段解释。
Laya 已经不只是一个模型权重:它包含英文、多语言和任务微调版本,也提供自动选择模型的 Router 和可自建的 HTTP 服务。本文会依次介绍模型类型、Python 本地使用方法,并说明它和 Jev AI 各自适合什么场景。
一、Laya Model 是什么
假设一个客服系统每天收到大量工单。应用可能需要知道应该把工单交给哪个团队、它有多紧急,以及客户是否明确要求退款。聊天模型可以用文字回答这些问题,但应用接下来还要解析文字,并确认答案是否符合自己的分类规则。
Laya 从答案的形状开始设计。你把工单和相关上下文作为 state(状态) 传入,再给出一个或多个 typed questions(类型化问题)。模型会对可能答案进行评分,返回结构化结果及概率;下一步路由或升级仍由应用代码负责。
模型卡把 Laya 称为非自回归的 “System 1” 决策模型。所谓“非自回归”,是指模型在一次计算中为候选答案打分,而不是逐个 token 生成一段长文本。它适用于分类、评分和路由,不是通用聊天助手。Laya 权重由 Convai Innovations 发布在 Hugging Face,Python 实现和用法见 Laya 代码仓库。
二、三个版本,各有用途
“Laya”通常指一组模型版本,并非可以任意互换的单一 checkpoint。当前模型卡介绍了以下三个版本:
| Checkpoint | 参数规模 | 主要用途 |
|---|---|---|
convaiinnovations/laya |
约 4.21 亿 | 英文文本;ModernBERT-large 主干;上下文长度 512 tokens |
convaiinnovations/laya-multilingual |
约 3.22 亿 | 多语言文本;mmBERT-base 主干;默认上下文长度 1,024 tokens,项目另有更长上下文的配置说明 |
convaiinnovations/laya-typed-decisions |
约 4.21 亿 | 针对 typed-decisions 评测微调的 ModernBERT-large 版本;上下文长度 1,024 tokens |
初次使用时,Python 的 Router 是较简单的入口。它会识别语言,并在英文与多语言模型之间选择。针对特定任务微调的版本是单独的选择,不要认为 Router 会在所有请求中自动使用它。版本和配置可能变化,使用前应查看当前模型卡。
开放权重让本地推理成为可能,但本地运行并不等于没有成本。你仍然要下载权重、安装推理环境,并为预计的流量准备足够内存与算力。Hugging Face 将英文 checkpoint 的权重标注为 Apache-2.0;部署时还应分别核对所用模型文件、软件包和依赖项的许可条款。
三、Laya 如何表达一次判断
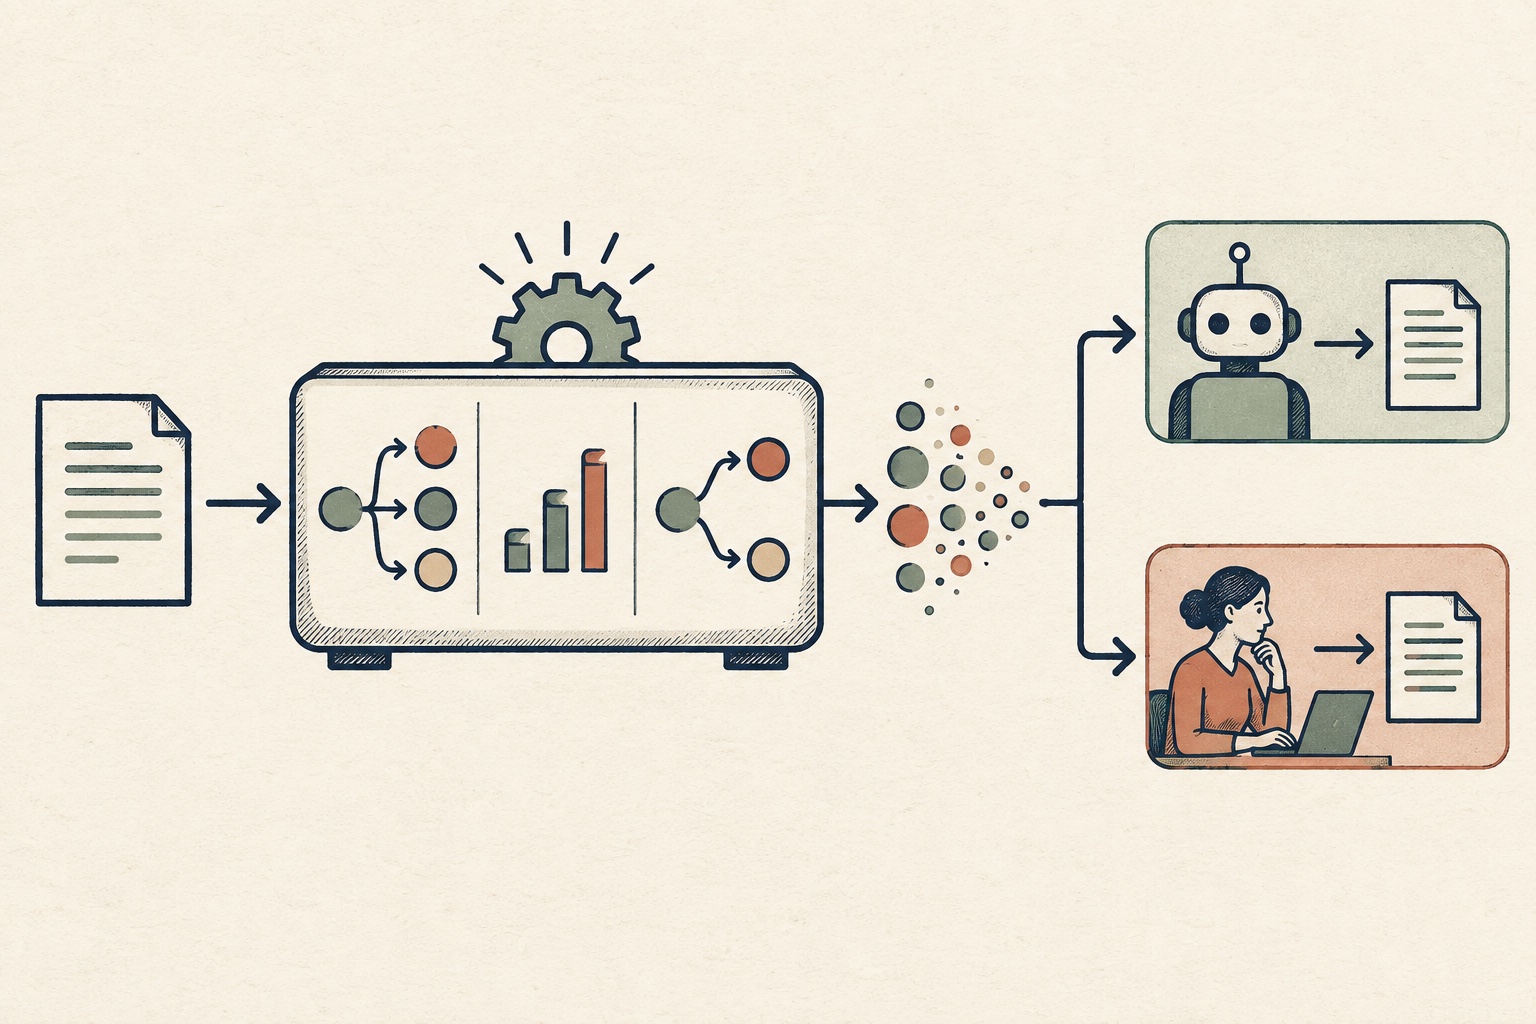
类型化问题会告诉模型,程序需要哪一种结果。Laya 主要提供三种原语:
choice: 从一组命名选项中选择,例如billing、technical或other。score: 按有序标准给出位置评分,例如“普通、需尽快处理、业务阻塞”。noul: 对一个明确的是非命题,返回其为真的概率。
概率描述模型对当前输入的输出,并不能证明判断正确。在用概率阈值触发面向客户的动作之前,应先用有标注的样本检查结果,并明确不确定时如何处理。
同一个请求里的所有问题都会读取同一份 state。例如,你可以一次询问工单所属团队、紧急程度和退款意图,再由业务规则决定如何分流。
四、在 Python 中安装和运行
Laya 的 Python 软件包支持 Python 3.10 及以上版本。建议创建虚拟环境,并用同一个环境安装依赖和运行程序。第一次推理可能会从 Hugging Face 下载所需 checkpoint;之后通常可以复用本地缓存。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install laya
Windows 用户可以通过 Python Launcher 创建和激活虚拟环境。如果你的机器需要指定 CPU 版或 GPU 版 PyTorch,请按平台说明先安装对应的 PyTorch,再安装 Laya。不同系统的完整命令见项目的 安装指南。
下面为一条客服工单定义三个独立问题:
from laya import Router

router = Router()  # 第一次使用时加载所需的语言模型。

state = {
    "subject": "重复扣款",
    "body": "我被扣了两次款,请退还多扣的费用。",
}

questions = {
    "department": {
        "type": "choice",
        "instructions": "这条工单应该交给哪个团队?",
        "criteria": {
            "billing": "付款、扣费和退款",
            "technical": "软件故障和产品错误",
            "other": "其他类型的问题",
        },
    },
    "urgency": {
        "type": "score",
        "instructions": "这条请求有多紧急?",
        "criteria": ["一般", "需要尽快处理", "业务阻塞"],
    },
    "refund_requested": {
        "type": "noul",
        "instructions": "客户是否明确提出退款?",
    },
}

result = router.predict(state, questions)
answers = result["answers"]
print(answers["department"]["choice"])
print(answers["urgency"]["score"])
print(answers["refund_requested"]["noul"])
predict 的第一个参数是所有问题共享的上下文。每个问题分别声明类型和标准,结果则按你定义的问题 ID 返回。代码里的工单和字段用于说明调用形状;接入真实动作之前,应先用自己的样本检查模型输出。
如果任务只使用某一种语言,也可以直接加载指定 checkpoint,而不通过 Router。如果要批量处理相似记录,SDK 还提供批量预测。这样能让团队控制加载哪个模型及其资源使用;相应地,你也需要自行确认选择的版本适合目标任务。
五、在本地启动 HTTP 服务
如果其他服务也需要调用 Laya,可以安装可选的 serve 扩展,启动自建 HTTP 服务。它的 POST /v1/systemone 请求格式兼容 Jev 的通信协议,因此一些现有客户端可以改用新的服务地址。协议兼容不代表模型、预测结果、服务政策或商业条款相同。
在本机试用时,先安装扩展、将服务绑定到本机地址,并设置 API key:
python -m pip install "laya[serve]"
export LAYA_HOST="127.0.0.1"
export LAYA_API_KEY="replace-with-a-private-random-key"
export LAYA_DEVICE="cpu"
laya-serve
然后向本地服务发送 state 和 typed question:
curl http://127.0.0.1:8000/v1/systemone \
  -H "Authorization: Bearer $LAYA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": {"body": "我们被重复扣款了,请退回多扣的费用。"},
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "这条工单应该交给哪个团队?",
        "criteria": {"billing": "付款和退款", "other": "其他问题"}
      }
    }
  }'
示例里的 Bearer key 是占位值,应在自己的环境中设置私有随机密钥。项目的服务示例会绑定到 0.0.0.0:8000,这可能让本机之外的设备也能访问。开发时应只监听本机回环地址;对外部署时则应配置认证、网络访问规则和正式的服务环境。其他启动参数见自建服务说明。
六、Laya 与 Jev AI 的区别
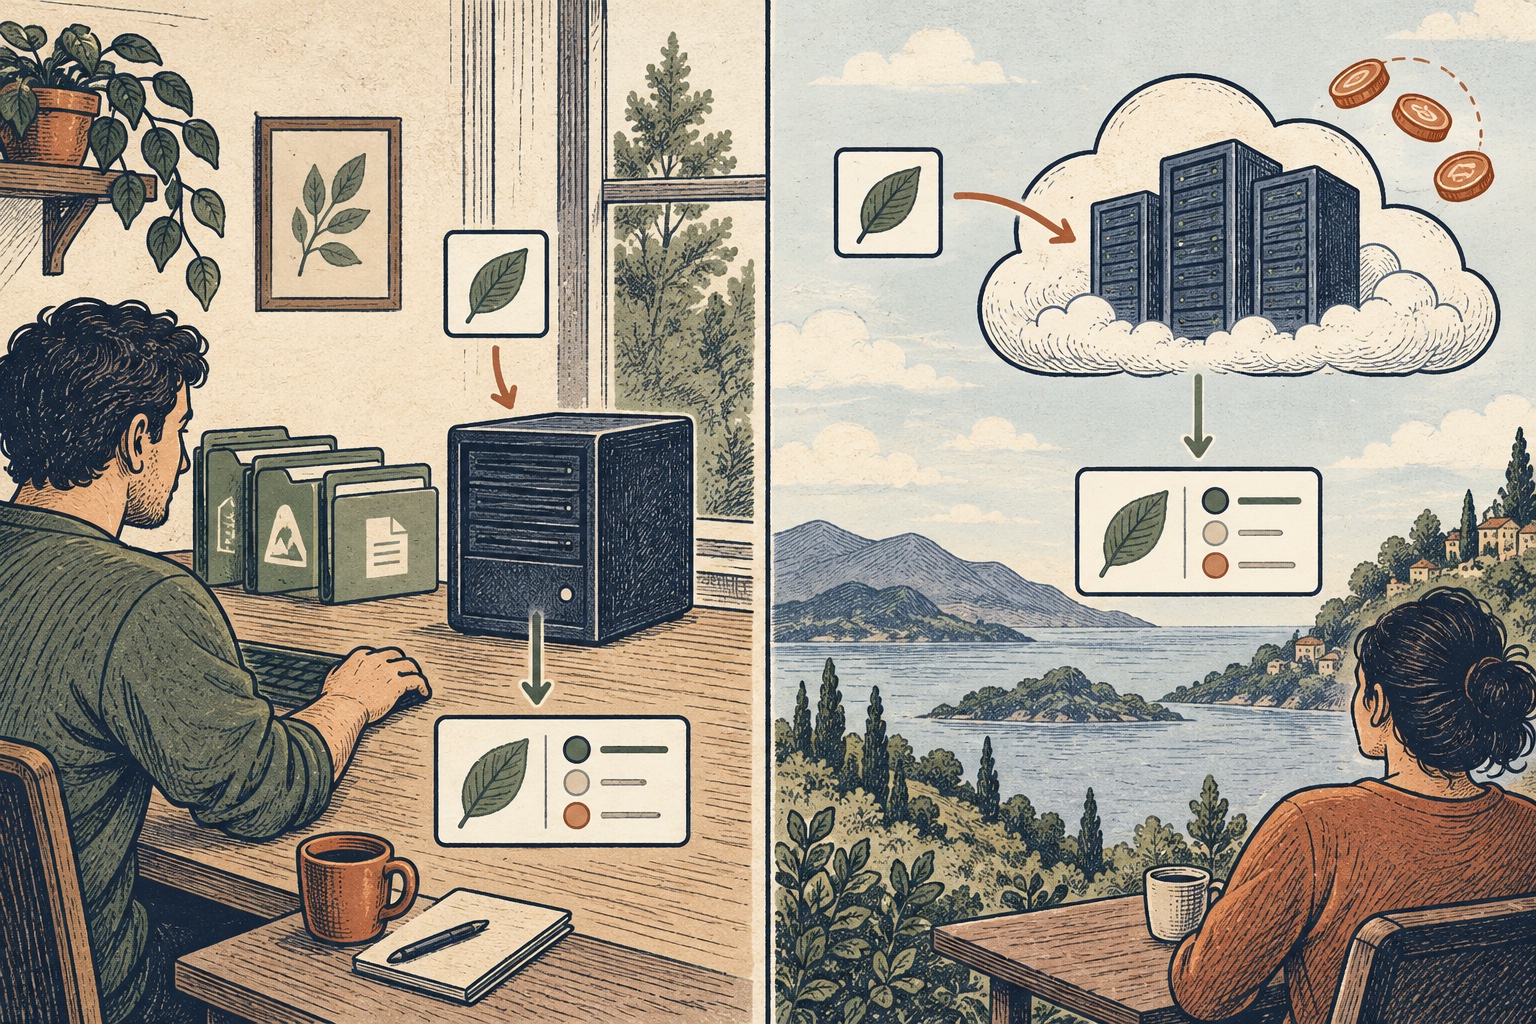
Laya 和 Jev 都使用类似的决策交互:输入状态,返回类型化答案。实际使用时,两者的主要区别是模型如何获得,以及由谁来运行和维护。
| 对比维度 | Laya | 通过 Jev AI Model 使用 Jev |
|---|---|---|
| 模型访问 | 可下载的开放权重;部分模型文件标注 Apache-2.0 | 托管 Jev 模型;本服务不提供模型权重 |
| 运行方式 | 下载后在自己的电脑或服务器上运行 | 在线工作台和托管 API |
| 前置工作 | 配置 Python/PyTorch、下载模型并准备推理资源 | 创建账号和 API key;无需维护本地模型服务器 |
| 网页试用 | 使用社区 Demo,或自己部署界面 | 登录后可在浏览器中免费运行决策 |
| API 费用 | 自建推理没有托管推理账单,但硬件、存储和运维仍有成本 | API 调用使用付费积分;网页登录后的 Playground 免费 |
| 控制权 | 自行选择 checkpoint 并管理服务 | 托管服务负责模型推理 |
如果想先体验一套已经托管好的决策工作流,可以试试 Jev model free。登录后可免费在浏览器 Playground 中运行决策;从自己的应用调用 API 则使用付费积分。Jev AI Model 是用于访问 Jev 的独立服务,不是模型开发者的账号,也不代表 Jev 与 Laya 是同一个产品。
当团队希望掌握开放权重、checkpoint 选择和推理环境时,可以评估 Laya;如果更想先通过网页和 API 运行,而不是维护模型服务,可以评估托管 Jev。无论选择哪种方案,都需要定义清楚答案范围、测试代表性样本、设定复核阈值,并把重要业务规则留在自己的应用代码中。
七、如何理解公开评测
目前能找到的对比可以提供线索,但它们回答的是不同问题,不应直接合并成一个排行榜。
Laya 项目自己的基准测试
Laya 代码仓库公布了 typed-decisions 基准评测结果。在项目报告中,针对该任务微调的 laya-typed-decisions 准确率为 0.766;英文基础模型为 0.362,多语言基础模型为 0.352。报告中的多数类基线是 0.461。这说明任务专门微调会显著影响结果,不能把微调版本和两个基础版本当成同一个“Laya 准确率”。
代码仓库也把已公开的 Jev 结果列在自己的测量旁边,但报告明确说明该项目没有亲自测量 Jev,双方使用的样本量和提示也不同。因此,这组数字只能作为不同来源的背景信息,不能当成受控的同场对比。可以查看基准报告及其限制,了解各项结果对应的 checkpoint 和测试条件。
一个小规模社区对比
你提供的 Hugging Face 讨论 #6 描述了另一项测试:100 条英文状态、310 个判断。作者称,测试问题完全相同;Laya 使用英文基础模型并在本地 CPU 运行,Jev 使用 1.13 API。三个小型测试集的报告分数分别是:Laya 在工单分类 0.800、安全护栏 0.883、内容审核 0.833;Jev 分别是 0.894、0.950 和 0.989。
该讨论也说明了局限:由一位作者手工标注,样本是预设数据的子集,只测了英文基础模型,没有使用 Laya 推荐的 Router。作者提到置信区间较宽,至少一个差异落在噪声范围内。五问题请求的延迟分别为本地 CPU Laya 375–476 ms、托管 Jev API 885–1,017 ms;两者运行环境不同,不能据此得出纯粹的硬件速度结论。
合起来看,这些结果适合用来提出问题,还不足以选出一个适用于所有场景的赢家。一个基准里,微调版和基础版的表现有明显差异;另一组小样本测试则显示 Jev 在该作者的标注数据上分数更高。实际结果会受到语言、候选选项、checkpoint、网络、硬件和错误成本影响。
更可靠的做法,是用准备部署的确切模型版本和端点,在同一组留出样本上测试相同问题定义。记录错误分流、概率校准、实际流量下的延迟、基础设施成本和人工介入比例,并加入模糊及超出范围的输入,而不只是简单样本。
八、上线前要检查的边界
结构化答案也可能判断错误。 模型返回了合法类别或概率,说明它满足了输出形式要求;这并不能证明它正确理解了业务政策。重要操作仍应保留确定性权限检查和人工复核路径。
概率需要在自己的数据上验证。 模型卡谈到了温度拟合和概率校准限制。在用置信度阈值自动批准、拦截、退款或升级请求前,先用自己标注的样本测量概率质量。
选项很多时要额外测试。 Laya 项目报告指出,候选标签较多时会出现性能问题,其中包括 Banking77 对比。如果类别很多,应直接测试这一规模,或者先粗略分类,再在子类中进行第二次判断。
语言路由并非万无一失。 Laya Router 使用轻量级语言与文字脚本识别。仓库文档提到,对于某些较短的拉丁字母文本,识别可能存在困难。若要处理多语言生产流量,应按语言分别核对模型选择与预测结果。
noul 的标签也要做正反样本测试。 模型卡记录了模型有时会对内置的 false 和 true 标签敏感。上线前,使用你准备采用的问题措辞,检查明确的肯定和否定样本。
本地部署会把运维责任交给团队。 你可以自己控制服务器和数据流向,但也要负责认证、网络暴露、模型下载、运行环境更新、监控和容量规划。缺少认证或网络访问控制的公网服务容易被滥用。
结语
Laya 是一组开放权重的结构化决策模型,提供 Python SDK、按语言路由和自建 HTTP 服务。Jev AI 则提供托管方式来体验相似的决策工作流。选择前,应使用自己标注的数据,测试真正计划部署的模型版本和运行方式。
资料核对日期: 2026-09-24。模型版本、命令和评测说明可能变化,部署前请查看原始文档。